层次结构——大写 T 树
大写 T 树是一种抽象数据类型,配合构造函数和选择函数,并用互递归对树进行映射。
大写 T 树导言(抽象数据类型)
在继续阅读之前,请注意:本节讨论的大写 T 树与 SICP 中的树不同。在 SICP(以及前面的章节)中,树只是深列表的花哨说法。本节我们将引入一个新概念——树(Trees),它是一种抽象数据类型(ADT,abstract data type)。这些树必须遵守特定的抽象屏障。日后大多数计算机科学家在现实中谈论树时,通常指的就是这种 ADT。
与列表和句子一样,我们也可以把数据存储在树这种数据结构中。树通常用于提供层次、次序和组合。
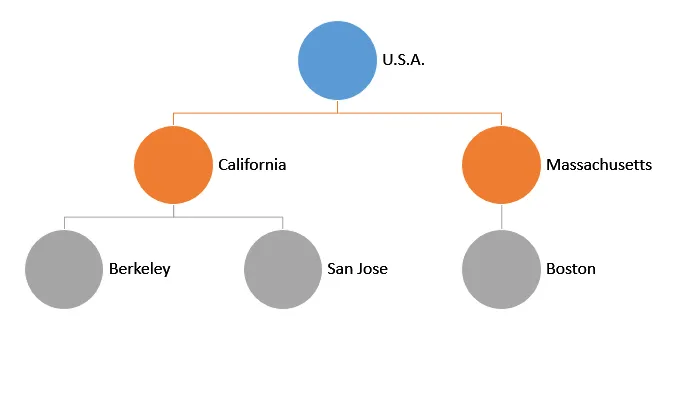
这个名字来源于它向下分支的结构,与现实中的树相似,只不过上下颠倒了。节点(node)是树上的一个点。每个节点包含一个数据元素(datum)(“U.S.A”、“California” 就是一些数据元素)。请注意,一个节点可以包含另一棵树。“California” 所在的节点可以看作一棵以 “California” 为顶端的树。正因如此,节点和树是同一回事!我们通常用”树(Tree)“指代整个结构。节点的另一个同义词是子树。
- 树的根(root)是最顶端的节点。每棵树只有一个根。在本例中,它就是 “U.S.A”。
- 一个节点的父节点(parent)是它正上方的节点。除根节点没有父节点外,所有节点都恰好有一个父节点。
- 一个节点的子节点(children)是它正下方的节点。“California” 的子节点是 “Berkeley” 和 “San Jose”。
- 分支节点(branch node)是至少有一个子节点的节点(如 “U.S.A”、“California” 和 “Massachusetts”)。
- 叶子节点(leaf node)是没有子节点的节点(如 “Berkeley”、“San Jose” 和 “Boston”)。
树抽象数据类型
我们有自己的一套 ADT 来表示树,本课余下部分都会使用它,但表示树并没有唯一的标准方法。为什么呢?因为在设计树 ADT 时有许多不同的选择:
- 分支节点可以有数据,也可以没有
- 二叉树(2 个分支)与 N 叉树(N 个分支)
- 子节点的次序
- 树可以为空吗?
- ……等等
树的不同表示方式会带来不同的限制、特性和功能。
以下是树的内置构造函数(constructor)和选择函数(selector):
- 构造函数:
make-tree接受两个参数——一个数据元素和它的子节点列表——并创建一棵树 ADT。 - 选择函数:
datum接受一个节点,返回该节点存储的数据元素。 - 选择函数:
children接受一个节点,返回它的子节点列表。
底层实现
实现上述树的一种方式如下:
(define (make-tree datum children)
  (cons datum children))
(define (datum node)
  (car node))
(define (children node)
  (cdr node))
选择函数 children 接受单个参数(一个节点),返回它的子节点,即一棵棵树的列表。树的列表称为森林(forest)。请记住,树和森林是两种不同的数据结构!此外,你应该把森林看作树的列表,但不应该把树看作一堆 cons、car 和 cdr。
重申一下:森林的构造函数和选择函数是 list、car 和 cdr,而(这种 ADT 的)树的构造函数和选择函数是 make-tree、datum 和 children。
另外,由于叶子是没有子节点的节点,我们可以用下面这样的谓词来判断一个节点是否是叶子:
(define (leaf? node)
(null? (children node)))请记住,使用列表只是表示树的一种方式。我们不能假定设计这个 ADT 的人会使用列表。例如,如果 maple 是一棵树,我们不能假定 (cdr maple) 会给出它的子节点。相反,我们必须尊重数据抽象,使用它们提供的构造函数和选择函数。
抽象屏障
我们怎么强调都不为过:你不能对树 ADT 的实现方式做任何假设。处理树时,你只能使用提供的构造函数/选择函数。由于森林实现为树的列表,你可以对森林用 car 找到第一棵树,或用 cdr 找到其余树组成的列表。
注意
处理树时,不能对树 ADT 的实现方式做任何假设,只能使用给定的构造函数和选择函数。
测试理解
假设 pine 指代的是一棵树,以下哪些是数据抽象(data abstraction)违规(DAV)?
选项:
(null? (children pine)):没问题,因为选择函数children总是返回森林,而森林是树的列表。对列表调用null?不是 DAV。(car (children pine)):没问题,因为选择函数children总是返回森林,而森林是树的列表。对列表调用car不是 DAV。(leaf? (car (children pine))):(car (children pine))返回pine的子节点中的第一个,它是一棵树。leaf?正是用于树的谓词。(datum pine):正确地返回pine中存储的数据元素。(car pine):数据抽象违规!(✅)我们不知道pine的 ADT 是否用列表实现,因此不能盲目假定(car pine)会返回它的数据元素。(cons pine (children pine)):这样做很奇怪,但并没有违反任何抽象屏障。它只是把pine前插到它的子节点列表(树的列表)中。
对树进行映射
我们经常需要对树做的一件有用的事,是把某个操作映射(map)到它上面,类似于对列表做映射。可以这样实现:
(define (treemap fn tree)
   (make-tree (fn (datum tree))
              (map (lambda (t) (treemap fn t))
                   (children tree) )))
我们把函数应用到数据元素上,并在子节点上递归地映射该函数。
请务必盯着上面的代码,直到它讲得通。
互递归
下面是定义 treemap 的另一种方式,把函数 fn 应用到整棵树。请注意,整体过程是递归的,但 treemap 并不直接调用自身。treemap(主要)负责把 fn 应用到单棵树的数据元素上。那谁来处理森林呢?treemap 会调用一个辅助过程 forest-map,由它把 fn 应用到森林中的所有元素。
(define (treemap fn tree)
    (make-tree (fn (datum tree))
               (forest-map fn (children tree))))
forest-map 如何把 fn 应用到森林呢?森林只是树的列表,而我们已经有了处理单棵树的 treemap。所以,我们要做的就是对森林中的所有树递归调用 treemap!
(define (forest-map fn forest)
    (if (null? forest)
        '()
        (cons  (treemap fn (car forest))
(forest-map fn (cdr forest)))))请注意,treemap 调用 forest-map,而 forest-map 又调用 treemap。A 调用 B、B 又调用 A 的模式称为互递归(mutual recursion)。

count-leaves
我们用互递归来写过程 count-leaves,它返回一棵树中叶子的数量。我们一步一步来。既然用互递归,就需要一个管理树的过程 count-leaves,和一个管理森林的过程 count-leaves-in-forest。
count-leaves:
- 基本情况: 如果节点是叶子,直接返回 1。
- 递归调用: 否则,调用
count-leaves-in-forest。
count-leaves 的代码如下:
(define (count-leaves tree)
  (if (leaf? tree)
      1
(count-leaves-in-forest (children tree))))count-leaves-in-forest:
- 基本情况: 如果森林是
null?,返回 0。 - 递归调用: 否则,我们需要求出森林中所有树的叶子总数。
- 对森林的
car调用count-leaves,求出森林中第一棵树有多少叶子。 - 对森林的
cdr递归调用count-leaves-in-forest,求出森林其余部分的叶子数。 - 最后,把这两个值相加,得到叶子总数。
- 对森林的
count-leaves-in-forest 的代码如下:
(define (count-leaves-in-forest forest)
  (if (null? forest)
      0
      (+ (count-leaves (car forest))
         (count-leaves-in-forest (cdr forest)))))
树的遍历
我们已经看到如何在树中存储和查找元素。现在,许多使用树这种数据结构的场景都涉及访问所有节点并处理其中的元素。显而易见的方式是从上到下、从左到右,但遍历树的方法还有很多。
深度优先搜索
深度优先搜索(DFS,Depth First Search)指先探索一个节点的所有子节点,再访问它的兄弟节点。这个名字源于你会先沿一条分支尽可能深入,再看其他分支。下面的动图演示了这一点,数字表示节点的访问顺序。

注意,它会在探索其他分支之前先走完一条分支。
我们可以在 Racket 中演示这一点。假设我们想打印每一个节点。我们的树 ADT 恰好遵循相同的结构,所以 DFS 的实现相当简单:
(define (depth-first-search tree)
    (print (datum tree))
    (for-each depth-first-search (children tree)))
广度优先搜索
广度优先搜索(BFS,Breadth First Search)先访问兄弟节点,再访问子节点。把它想象成按”层”来看这张图会更容易理解:先看树的根,再看它的子节点,接着是孙节点,以此类推。下面的动图演示了这一点:
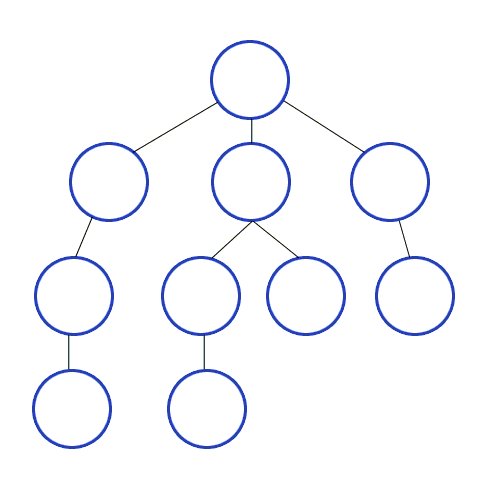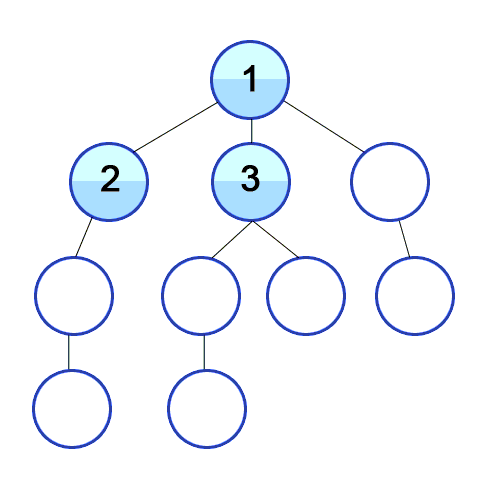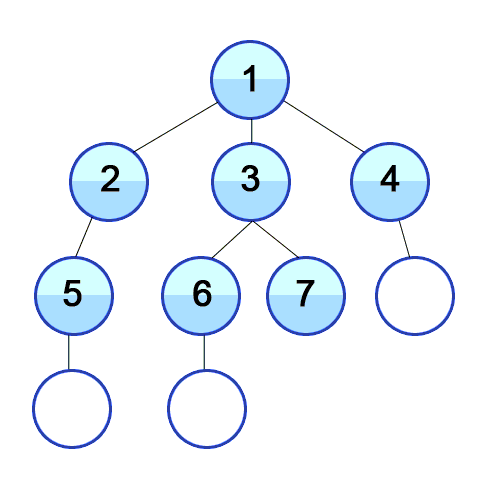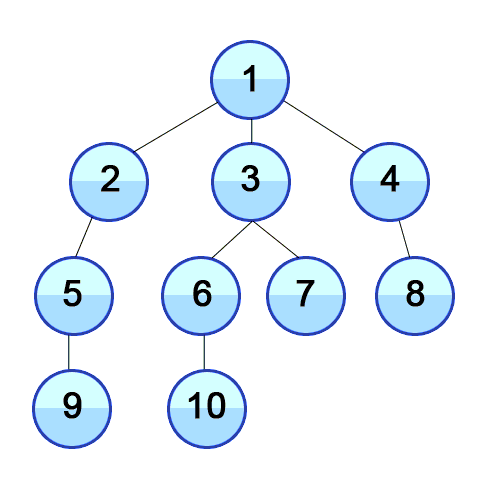
在 Racket 中实现 BFS 稍微难一点,因为我们的 ADT 存储信息的顺序与 BFS 遍历的顺序不同。一种解决办法是使用另一种名为队列(queue)的数据结构,它按顺序存储接下来要检查的节点。
(define (breadth-first-search tree)
    (bfs-iter (list tree)))

(define (bfs-iter queue)
    (if (null? queue)
        'done
        (let ((task (car queue)))
            (print (datum task))
            (bfs-iter (append (cdr queue) (children task))))))
BFS 示例
我们用下面这棵树来逐步演示上述代码的工作原理。图中的箭头表示父节点 → 子节点的关系。

首次调用 bfs-iter 时,整棵树被放入 queue。为简化起见,我们用树的根来指代一棵树。
queue:F
它出队节点 F,打印 F 的值,然后用队列的其余部分加上 F 的子节点递归调用 bfs-iter。此时队列的其余部分为空,但 F 的子节点是 B G。
queue:B G
bfs-iter 会打印队列中第一棵树的节点 B,然后用队列的其余部分 G 加上 B 的子节点 A D 递归调用 bfs-iter。
queue:G A D
如此继续,直到队列为空。队列为空时,每个节点的数据元素都恰好被打印了一次。
注意,兄弟节点总是排在队列前面,子节点从队尾进入。这保证了先检查兄弟节点,再检查子节点。
DFS 与 BFS 之辨
哪一个更好?取决于你想用树做什么,以及你如何在树中存储元素。
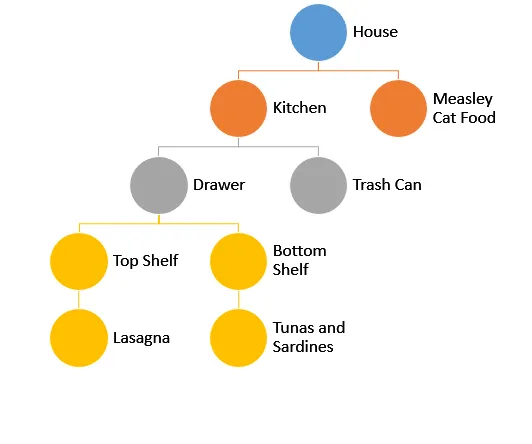
下面这棵树表示房子里的东西。在”房子(House)“里可以找到”厨房(Kitchen)“和”猫粮(Cat Food)“。在”厨房”里可以找到”抽屉(Drawer)”、“垃圾桶(Trash Can)“等。叶子里装着食物,而且越深,食物越顶饱。
测试理解
考虑一棵与上面结构类似的树。假设你是一只饥肠辘辘的猫,想尽快找到任何食物填饱肚子。下面这种情况更适合哪种树遍历?
选项:
- BFS:正确!(✅)用 BFS,你会先探索 House,然后是 Kitchen,接着是 Measley Cat Food,然后停下。今晚不会饿肚子了。
- DFS:用 DFS,你会探索 House、Kitchen、Drawer、Top Shelf,最后才到 Lasagna 才停下。千层面固然美味,但明明有更快吃到东西的办法。
- 没有区别:提示:BFS 要探索多少个节点?DFS 要探索多少个节点?
你仍然是那只猫,但现在你的目标是找到房子里最美味的食物。哪种树遍历能帮你最快找到它?
选项:
- BFS:不,你才不会满足于一点点 Measley Cat Food。你会继续探索,在找到千层面之前已经访问了八个节点。你可以做得更好。
- DFS:正确!(✅)你只需要探索五个节点,就能找到美味的千层面。
- 没有区别:提示:BFS 要探索多少个节点?DFS 要探索多少个节点?
要点总结
本小节要点如下:
- 记住你的构造函数和选择函数(
make-tree、datum和children)。 - 要对树进行映射,我们使用互递归,即两个过程相互定义。通常,其中一个过程接受一棵树,另一个接受一片森林。
- 广度优先搜索先看同一层的节点,而深度优先搜索则沿每条分支一直走到叶子节点。