集合的表示
用列表、有序列表和二叉树表示集合,并分析各种表示下操作的运行时间。
集合导言
我们已经看到如何用列表或树给结构引入层次。有时我们并不关心结构的层次,只需要知道某个数据元素是否在结构中。集合(set)就是适合这种需求的结构——它是唯一数据元素组成的汇集。换句话说,集合绝不会包含两个相同的元素。例如,{cats dogs bears squirrels cats} 不是集合,因为 “cats” 出现了两次。相比之下,{cats dogs bears squirrels} 是集合。
本课中,我们用列表来表示集合 ADT。这意味着我们可以用 list 创建集合,用 car 和 cdr 从集合中选取元素。空集合用空列表 null 表示。接下来,我们将为集合 ADT 定义以下函数:
element-of-set?检查某个数据是否在集合中adjoin-set向集合中添加一个新数据。intersection-set给定两个集合,返回只包含两个集合共有元素的新集合
element-of-set?
element-of-set? 接受两个参数——元素 x 和集合 set——如果 x 在 set 中就返回 #t,否则返回 #f:
(define (element-of-set? x set)
  (cond ((null? set) #f)
        ((equal? x (car set)) #t)
        (else (element-of-set? x (cdr set)))))
这段代码与 memq 类似。我们使用 equal?,因为集合的元素可以是数字、符号或其他任何东西。
测试理解
假设 set1 和 set2 的长度都是 。
下面这个函数调用的运行时间是多少?
(element-of-set? (car set1) set2)选项:
- :正确!(✅)最坏的情况是
(car set1)不在 set2 中。这时,我们需要把(car set1)与 set2 中全部 个元素都比较一遍。
adjoin-set
接着说 adjoin-set!这个函数同样接受元素 x 和集合 set。如果 x 是 set 的成员(我们可以用 element-of-set? 函数检查),就什么也不做。否则,把 x 加入 set:
(define (adjoin-set x set)
  (if (element-of-set? x set)
      set
      (cons x set)))
intersection-set
intersection-set 稍有难度。给定两个集合 set1 和 set2,我们需要求出它们的交集。我们必须递归地完成。把这个问题分成几种情况:
- 如果任一集合为空,返回
null。 - 检查
(car set1)是否在 set2 中。- 如果是,把该元素加入答案,并对
(cdr set1)和 set2 递归调用intersection-set。 - 如果不在 set2 中,对
(cdr set1)和 set2 递归调用intersection-set。
- 如果是,把该元素加入答案,并对
intersection-set 的代码如下:
(define (intersection-set set1 set2)
  (cond ((or (null? set1) (null? set2)) '())
        ((element-of-set? (car set1) set2)
         (cons (car set1)
               (intersection-set (cdr set1) set2)))
        (else (intersection-set (cdr set1) set2))))
测试理解
假设 set1 和 set2 的长度都是 。
下面这个函数调用的运行时间是多少?
(intersection-set set1 set2)选项:
- :正确!(✅)最坏的情况下,set1 与 set2 完全没有共同元素。对于 set1 中的每个元素,都要花 时间检查它是否在 set2 中。这意味着我们对一个 函数做 次迭代,总运行时间为 。
用有序列表表示集合
你可能已经注意到,我们之前对集合 ADT 的实现相对较慢。求两个集合的交集,运行时间相对其大小可能是平方级的。如果集合相当大,这个实现会非常慢。但别担心,我们可以改用有序集合(ordered sets)来提速——数据必须按递增顺序存储。例如 (1 3 4) 是有序集合,而 (1 5 3 4) 不是。
就像按字母顺序排列姓名能让名册更易查找一样,用有序列表表示集合,能让查找和操作明显变快。
element-of-set?
有序列表的一大优点是:查找某个元素时,我们不必总是遍历整个集合。我们对 element-of-set? 做必要的修改,让它利用有序这一特性。
element-of-set? 仍然接受两个参数——元素 x 和集合 set。既然知道 set 中的元素是有序的,我们需要做的只是从左到右扫描集合。
- 如果
(car set)等于x,就停下并返回#t。 - 否则,如果
(car set)大于x,那么我们知道集合中其余元素都大于x,可以就此停下并返回#f。 - 再否则,如果
(car set)小于x,就得移向set中的下一个元素,重复上述过程。
这意味着,如果运气好——x 小于或等于 set 的第一个元素——我们甚至不用看集合的其余部分,就可以直接返回 #f 或 #t!
element-of-set? 的代码如下:
(define (element-of-set? x set)
  (cond ((null? set) false)
        ((= x (car set)) true)
        ((< x (car set)) false)
        (else (element-of-set? x (cdr set)))))
笔记
这里我们假设集合中的所有元素都是数字。如果不是,上述代码会报错。
测试理解
假设 set1 和 set2 都是有序列表,且长度都是 。
下面这个函数调用的运行时间是多少?
(element-of-set? (car set1) set2)选项:
- :正确!(✅)最坏的情况是
(car set1)大于或等于 set2 中最大的元素。由于集合是有序的,这意味着我们要把(car set1)与 set2 的所有元素都比较一遍,才能返回#t或#f。尽管使用有序列表确实在某些情况下让这个函数更快,但最坏情况下的运行时间与用无序列表时相同。
intersection-set
我们之前用无序列表实现的 intersection-set,要把一个集合的每个元素与另一个集合的每个元素都比较,总运行时间为 。为了用有序列表给这个函数提速,我们换一种方式来实现。可以把它分为(与之前相同的)基本情况:
- 如果任一集合为空,返回
null
以及以下递归情况:
(= (car set1) (car set2)): 由于它们有相同元素,我们把该元素加入答案,从两个集合中移除该元素,并通过调用(intersection-set (cdr set1) (cdr set2))检查其余部分。(< (car set1) (car set2)): 由于(car set2)是 set2 中最小的元素,我们可以断定(car set1)小于 set2 的所有元素,因此它不可能在 set2 中。我们可以用 set1 中第二小的元素继续查找,即调用(intersection-set (cdr set1) set2)。(> (car set1) (car set2)): 这是上一种情况的镜像。由于(car set1)是 set1 中最小的成员,我们知道(car set2)小于 set1 的所有元素,因此它不可能在 set1 中。我们可以用 set2 中第二小的成员继续查找,即调用(intersection-set set1 (cdr set2))。
intersection-set 的完整代码如下:
(define (intersection-set set1 set2)
  (if (or (null? set1) (null? set2))
      '()
      (let ((x1 (car set1)) (x2 (car set2)))
        (cond ((= x1 x2)
               (cons x1
                     (intersection-set (cdr set1)
                                       (cdr set2))))
              ((< x1 x2)
               (intersection-set (cdr set1) set2))
              ((< x2 x1)
               (intersection-set set1 (cdr set2)))))))
测试理解
假设 set1 和 set2 都是有序列表,且长度都是 。
下面这个函数调用的运行时间是多少?
(intersection-set set1 set2)选项:
- :正确!(✅)最坏的情况是我们必须在算法终止前遍历两个集合。一个例子是两个集合包含交错的数值(如
(1 3 5)和(2 4 6))。试着用这两个集合逐步走一遍intersection-set。你看到为什么运行时间是 了吗?提示:(其中 为非零常数)可以化简为 。
用二叉树表示集合
“我想更快”
对速度的渴求,我们必须挣脱把我们束缚在线性结构上的列表锁链。换句话说,如果想让集合 ADT 跑得更快,就得用列表以外的数据结构。用树怎么样?
二叉树(binary tree)与本课前面描述的树十分相似,只差一个重要特性:二叉树的每个节点最多可以有两条分支。
用二叉树表示集合简单而直观。二叉树中每个节点的条目(entry)(类似于数据元素 datum)是集合中的一个元素。每个节点还有一条左分支(left branch)和一条右分支(right branch),左右分支都可以为空。如果两条分支都为空,该节点就是叶子。这个数据结构必须遵守一条规则:节点的左分支必须指向条目小于该节点条目的子树,右分支必须指向条目大于该节点条目的子树。换句话说,节点左侧的所有值都必须小于该节点,右侧的所有值都必须大于该节点。

这条规则把对数运行时间引入了画面。自己在左上方那棵树里找找 11。我们从树的根开始,注意到 11 大于 7,于是沿右分支下行。11 大于 9,于是再次沿右分支下行。我们在树中找到了 11,可以返回 #t。
好了,现在我们来证明这个对数运行时间。如果你不想看完整证明,可以跳到 TL;DR 小节。
看看下面这棵最坏情况的树:
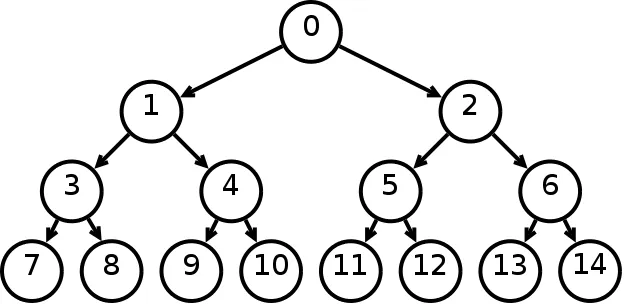
- 你最多需要探索的节点数等于树的深度(depth),即树有多少层。(根处的深度为 1。)花点时间确认这一点。
- 已知集合大小为 ,因此树中有 个节点。
- 深度 1 处有 1 个()节点。深度 2 处共有 3 个()节点。深度 3 处共有 7 个()节点,……最后,深度 处共有()个节点。
我们在第 3 课学过,在渐近分析中可以忽略常数,所以干脆说深度 处共有 个节点。这意味着任何深度为 的树都有 个节点。
我们知道树中共有 个节点。也就是说 。
经过一番巧妙的代数变换,我们得到 。
还记得我们说过,最多需要探索的节点数等于树的深度吗?这意味着在二叉树中查找节点的运行时间为 。如此,我们证明了用二叉树表示集合的对数运行时间。呼!
提示
TL;DR: 二叉树结构的有序性,让我们每次比较后都能忽略半棵树。这意味着我们最多需要探索的节点数等于树的深度。这带来了 的运行时间。例如,在一棵有 8 个节点的树中,我们最多只需 3 次比较就能到达任何叶子。在一棵有 16 个节点(是之前两倍)的树中,我们只需 4 次比较(只多 1 次!)就能到达任何叶子。
实现二叉树
实现二叉树的一种方式是用列表,第一项是元素,第二项是左子树,第三项是右子树。
(define (entry tree) (car tree))
(define (left-branch tree) (cadr tree))
(define (right-branch tree) (caddr tree))
(define (make-tree entry left right)
  (list entry left right))
element-of-set?
我们可以用下面的代码,把查找元素是否在集合中的算法形式化:
(define (element-of-set? x set)
  (cond ((null? set) false)
        ((= x (entry set)) true)
        ((< x (entry set))
         (element-of-set? x (left-branch set)))
        ((> x (entry set))
         (element-of-set? x (right-branch set)))))
超级简单。
adjoin-set
如何往二叉树中添加元素?由于你需要决定把 加到左子树的叶子还是右子树的叶子,我们沿用上面 element-of-set? 的算法。
- 如果树为空,就造一棵条目为 、左右分支都为空的树。
- 如果 等于树的节点条目,返回这棵树。(这意味着 已在树中,无需改动。)
- 如果 小于树的节点条目,前往左子树。
- 如果 大于树的节点条目,前往右子树。
下面是 adjoin-set 的正式算法:
(define (adjoin-set x set)
  (cond ((null? set) (make-tree x '() '()))
        ((= x (entry set)) set)
        ((< x (entry set))
         (make-tree (entry set)
                    (adjoin-set x (left-branch set))
                    (right-branch set)))
        ((> x (entry set))
         (make-tree (entry set)
                    (left-branch set)
                    (adjoin-set x (right-branch set))))))
不平衡的树

上图是把 1、2、3、4、5、6、7 按此顺序加入空树的结果。(务必用纸笔自己试一遍,确认确实如此。)我们说这棵树是不平衡的(unbalanced),因为树的一侧元素远多于另一侧。
测试理解
在上面这棵不平衡的树中,查找一个元素(例如 7)的运行时间是多少? 是树中节点的数量,此处 。
选项:
- :正确!(✅)如前所述,查找元素时最多需要探索的节点数等于树的深度。在这个特例中,深度 ,即节点数。因此运行时间为 。
树的不同类型
此前,我们看到树中的节点可以有任意数量的子节点。这类树有时称为 N 叉树(N-way trees)。对于 N 叉树,我们把树的子节点存为一片森林,即树的列表。我们通过选择函数 (children <tree>) 取出这片森林。
上一节中,我们看到了更具体的一种树——二叉树。这种树中每个节点最多有 2 个子节点,可以用 (left-branch <tree>) 和 (right-branch <tree>) 访问。二叉树的构造函数也与 N 叉树的构造函数不同。
处理树时,先弄清你处理的是哪种树,并留意题目提供了哪些构造函数和选择函数。二叉树的构造函数和选择函数用在 N 叉树上会完全行不通!
要点总结
集合是一种每个元素只出现一次的特殊数据结构。表示集合的方式有多种(其实所有数据结构都基本如此)。表示方式的选择会影响各个函数的运行时间。