MapReduce
介绍 MapReduce 的背景、分解步骤(映射、分桶排序、归约)以及链式用法。
MapReduce 简介
本节中,我们将重温第 2 单元的高阶函数(map 和 accumulate),并把它们与并行性结合起来,使我们能够高效地处理海量数据。
MapReduce 的背景
Google 的工程师注意到,他们的大部分计算都可以分解为:先对某个数据 map 一个函数,然后再接一个 accumulate(也叫 reduce,名字即由此而来)。其结果是一个名为 mapreduce 的库过程,它接收两个函数作为实参:一个充当 mapper,另一个充当 reducer。它接收一大块数据,把它们分成较小的部分,对较小的数据应用 mapper,再用 reducer 合并结果。MapReduce 处理与并行相关的一切,我们只需提供这两个函数。
尽管这看起来可能就是 mapreduce 在做的事,但这不是 mapreduce:
(define (mapreduce mapper reducer base-case data)
    (accumulate reducer base-case (map mapper data)))
为什么这不是 mapreduce?因为它不处理数据的划分、并行地应用 mapper,以及在归约之前对结果排序。不过它做对的一点是:想用 mapreduce 的人只需传四个实参:mapper、reducer、base-case 和我们想处理的 data。
如果你有兴趣,可以看看这里这篇由提出 mapreduce 的 Google 员工撰写的论文。它不要求阅读,但相当易读有趣。旧版讲义也有不错的解释,如果你觉得自己还不懂 mapreduce,应该读一读。
MapReduce 的分解
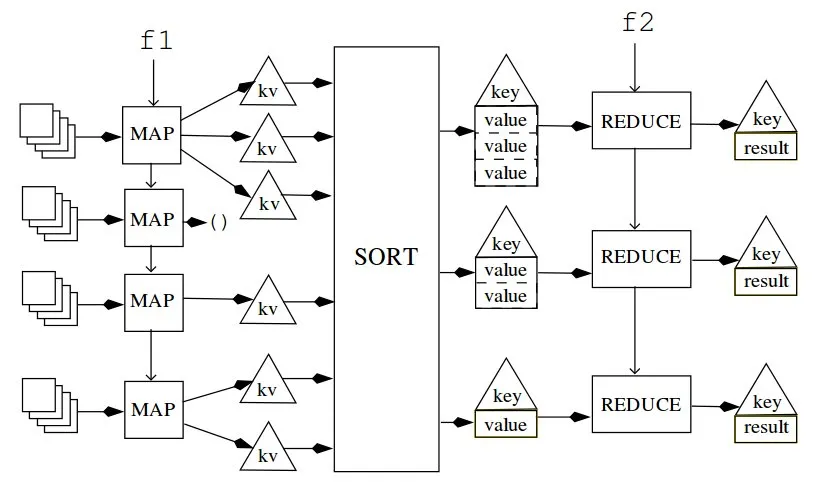
- 把
mapper映射(map)到较小的数据上(并行完成)。这涉及选择我们想处理的输入部分,并给每个结果”贴上”一个键(key)。 - 根据键把结果排序到”桶(bucket)“中。
- 每个”桶”被传给一个
reducer,由它累积这些值。
我们将在后续各节中更详细地讨论其中的每一步。
本课中,我们将始终使用”搜索文本文件并统计词频”作为例子。
这将作为我们的测试文件:
>(define song1   '( ((please please me) i saw her standing there)
            ((please please me) misery)
            ((please please me) please please me)))

>(define song2   '( ((with the beatles) it wont be long)
            ((with the beatles) all ive got to do)
            ((with the beatles) all my loving)))

>(define song3   '( ((a hard days night) a hard days night)
            ((a hard days night) i should have known better)
            ((a hard days night) if i fell)))

>(define all-songs (append song1 song2 song3))
( ((please please me) i saw her standing there)
  ((please please me) misery)
  ((please please me) please please me)
  ((with the beatles) it wont be long)
  ((with the beatles) all i have got to do)
  ((with the beatles) all my loving)
  ((a hard days night) a hard days night)
  ((a hard days night) i should have known better)
  ((a hard days night) if i fell) )
注意每一行都用它们的标题”标记”了。我们建议在某个地方开着这个标签页,方便你知道我们的输入长什么样。
你可以从这里获取这份数据以及我们 mapreduce 实现中的其他函数。注意这个实现不涉及并行。
Mapper
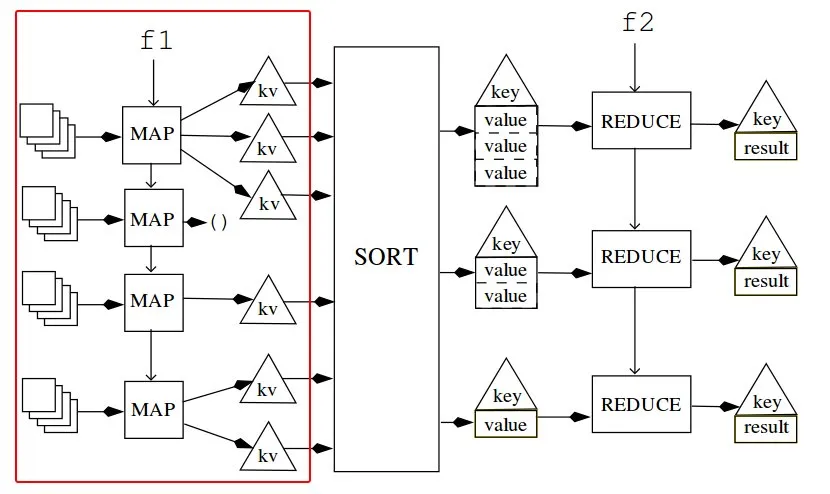
(map mapper data)- 输入:(较小的)一个键值对(key-value pair)
- 输出:键值对的表
mapper 是一个接收数据(作为键值对)并返回键值对表的函数。键值对表与我们在第 9 课玩过的关联表(associative lists,也叫 a-lists)相同。键用于跟踪数据来自哪里;这对并行化很重要。注意,输入的键不一定与 mapper 输出的键相同。这将是我们的键值对抽象数据类型(ADT):
(define make-kv-pair cons)
(define kv-key car)
(define kv-value cdr)
如果我们看示例输入的第一项,结果如下:
>(kv-key '((please please me) i saw her standing there))
(please please me)
>(kv-value '((please please me) i saw her standing there))
(i saw her standing there)
为什么输出的是键值对表而不是单个键值对?原因如下:
- 没有键值对:有些情况下我们的数据不包含我们感兴趣的键。例如,想象你想统计一个单词中元音字母的数量,遇到单词 ‘fly’。这种情况下我们返回空表。
- 多个键值对:有些情况下我们的数据对应两个或多个我们想产生的键。这适用于我们的歌词例子(如下所示)。
扩展示例:词频统计
下面是我们例子的 mapper 定义。
>(define (mapper input-kv-pair)
    (map (lambda (wd) (make-kv-pair wd 1)) (kv-value input-kv-pair)))

>(mapper '((please please me) i saw her standing there))
((i . 1) (saw . 1) (her . 1) (standing . 1) (there . 1))

>(mapper '((please please me) please please me))
((please . 1) (please . 1) (me . 1))
我们的 mapper 做什么?它接收一个键值对(键是歌曲标题,值是歌词中的一行)。对行中的每个单词,用该单词作为新键,并配以值 1。注意,即使一个单词在行中出现两次,比如 (please please me),它输出两次 (please . 1),而不是 (please . 2)。这没问题,因为这里我们只是把每个的计数初始化为 1,稍后再把它们加起来。
sort-into-buckets
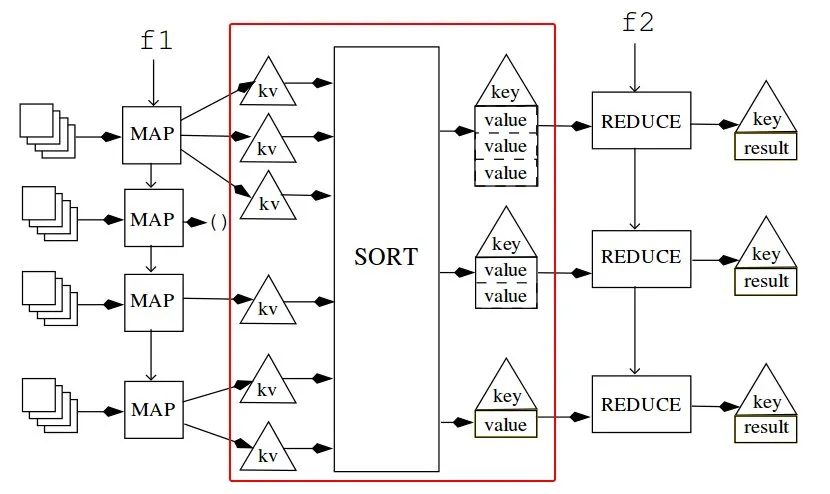
在我们真正进入 reducer 之前,有一个中间步骤对键排序,把相同的键归到一起。幸运的是,我们可以利用抽象,用函数 sort-into-buckets 帮我们把它们排序到”桶”中。具有相同键的键值对被归到同一个”桶”下。这是调用上一步 mapper 的结果:
>(map mapper all-songs)
( ((i . 1) (saw . 1) (her . 1) (standing . 1) (there . 1))
  ((misery . 1))
  ((please . 1) (please . 1) (me . 1))
  ((it . 1) (wont . 1) (be . 1) (long . 1))
  ((all . 1) (i . 1) (have . 1) (got . 1) (to . 1) (do . 1))
  ((all . 1) (my . 1) (loving . 1))
  ((a . 1) (hard . 1) (days . 1) (night . 1))
  ((i . 1) (should . 1) (have . 1) (known . 1) (better . 1))
  ((if . 1) (i . 1) (fell . 1)) )
调用 sort-into-buckets 得到如下结果:
>(sort-into-buckets (map mapper all-songs))

'( ((i . 1) (i . 1) (i . 1) (i . 1))
   ((saw . 1))
   ((her . 1))
   ((standing . 1))
   . . .
   ((all . 1) (all . 1))
   ((have . 1) (have . 1))
   . . .
   ((if . 1))
((fell . 1)) )为保持简短,省略了部分结果。注意这里键和值是如何组织的。结果是一个桶的表,其中每个桶是具有相同键的键值对表。((i . 1) (i . 1) (i . 1) (i . 1)) 就是一个桶的例子,其中每个键值对的键都是 ‘i’。
Reducer
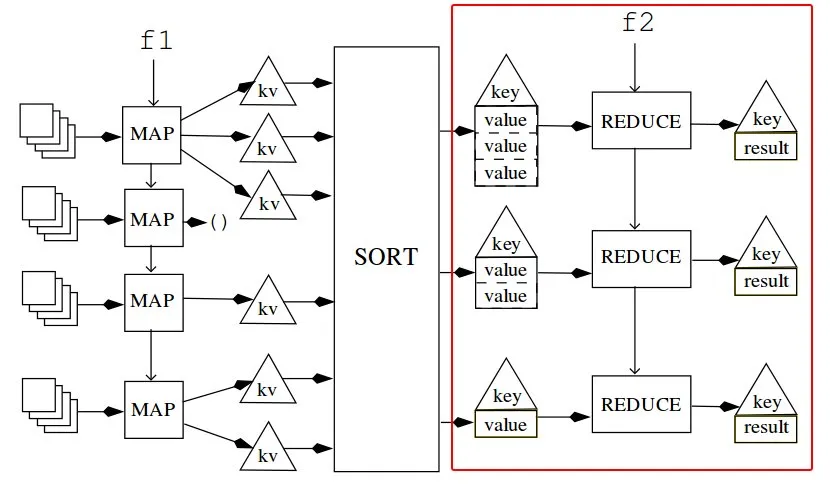
- 输入:两个”值”
- 输出:一个值
reducer 接收两个值(不含键),输出单个值。这将是与那个特定键关联的输出。
扩展示例:词频统计
下面是我们 reducer 的定义:
(define (reducer num other-num)
    (+ num other-num))
归约一个桶
注意我们的 reducer 接收两个值,而上一步(sort-into-buckets)的结果是一个桶的表(其中每个桶是键值对表)。让我们看看如何把 reducer 用在单个键值上。让我们用我们的第一个键值对表:
((i . 1) (i . 1) (i . 1) (i. 1) (i . 1))> (accumulate reducer 0 (map kv-value '((i . 1) (i . 1) (i . 1) (i . 1) (i . 1))))这简化为:
> (accumulate reducer 0 '(1 1 1 1 1))5调用 accumulate 之前,我们必须先用 map 从键值对表中取得各个值。注意调用 accumulate 的结果是单个值(即 5),与键(本例中是 ‘i’)关联。因为我们的最终结果需要是一个键值对,最后我们必须返回 (i . 5)。于是表达式变成:
(make-kv-pair (kv-key '(i . 1))
              (accumulate reducer 0 (map kv-value '((i . 1) (i . 1)
                                    (i . 1) (i . 1) (i . 1)))))
我们可以把上面的表达式推广到除 ((i . 1) (i . 1) (i . 1) (i . 1) (i . 1)) 之外的任何其他”桶”。
(define (reduce-bucket reducer base-value bucket)
    (make-kv-pair   (kv-key (car bucket))
            (accumulate reducer base-value (map kv-value bucket))))
归约桶表
上面的过程 reduce-bucket 归约一个桶。我们上一步的结果 (sort-into-buckets (map mapper data)) 是一个桶表。要归约桶表,我们可以再用一次 map。我们将定义函数 group-reduce,它正是做这个的。
(define (groupreduce reducer base-case buckets)
    (map (lambda (bucket) (reduce-bucket reducer base-case bucket))
             buckets))
如果我们使用目前已有的东西,它求值为:
>(groupreduce reducer 0 (sort-into-buckets (map mapper all-songs)))
( (i . 4) (saw . 1) (her . 1)
  . . .
  (misery . 1) (please . 2) (me . 1)
  . . .
  (all . 2) (have . 2))
为简洁省略了一些值。最终结果又是键值对表:键是单词,值是该单词在我们数据中出现的次数。我们刚刚用 mapreduce 构造了数据中单词的词频统计!
这是我们 mapreduce 最终的(手工简化过的、近似的)定义:
(define (mapreduce mapper reducer base-case data)
    (groupreduce reducer base-case (sort-into-buckets (map mapper data))))
为什么它不是真正的 mapreduce?真正的 mapreduce 会涉及并行地映射和归约我们的键值对,而且我们必须考虑并发问题。上面的定义捕捉了我们关心的主要部分。
MapReduce 练习
编写 mapreduce 函数的关键在于定义你的 mapper 和 reducer。我们准备了一系列不同的场景,希望你定义相应的 mapper、reducer,最后是对 mapreduce 的调用。
记住:
- mapper 的输入是键值对,输出是键值对表。
- reducer 的输入是两个值,输出是一个值。
链式 MapReduce
如前面所暗示的,由于 mapreduce 接收键值对表作为输入并输出键值对表,可以把多个 mapreduce 链接起来。它看起来像这样:(mapreduce some-mapper some-reducer some-base-case (mapreduce another-mapper another-reducer another-base-case actual-input))。注意第一个 mapreduce 的键和值可能与第二个 mapreduce 的完全不同。
最高频的词
让我们再写一个 mapreduce 函数(这次还不链接)。我们的输入的键是 ‘words’,值是数字,表示它们在文档中出现的次数。我们希望输出是单个键值对的表,与输入一样,键是单词,值是数字,且是遇到的最大数字。
笔记
注意:我们的解决方案并不理想,有点牵强。它没有利用 mapreduce 提供的并行性。
>(define x (list (make-kv-pair her 1) (make-kv-pair i 4) (make-kv-pair saw 1))
>(most-frequent x) ; i 出现得最多
((i . 4))
现在我们来链接
如果我们传入键为单词、值为数字的键值对,我们上面的函数可以工作。在现实生活中,我们可能无法直接得到每个单词的词频;我们必须从原始文档处理得到。
编写函数 real-most-frequent,它接收键值对表,其中键是文件名,值是该文件中的行(就像我们的 all-songs 例子)。我们的输出又是单个键值对的表。你可以重用本课中目前为止定义的任何函数。
>(real-most-frequent all-songs)
((i . 4))
笔记
本教材不包含 MapReduce 练习。如果你想多练习,第 14 课的讨论中有 MapReduce 题目。