字典与记忆化
Python 字典的创建、访问与常用操作,以及用字典做缓存实现记忆化,加速斐波那契等递归计算。
字典
字典(dictionary)和列表很像,区别在于它不用索引来引用值,而是用键(key)。
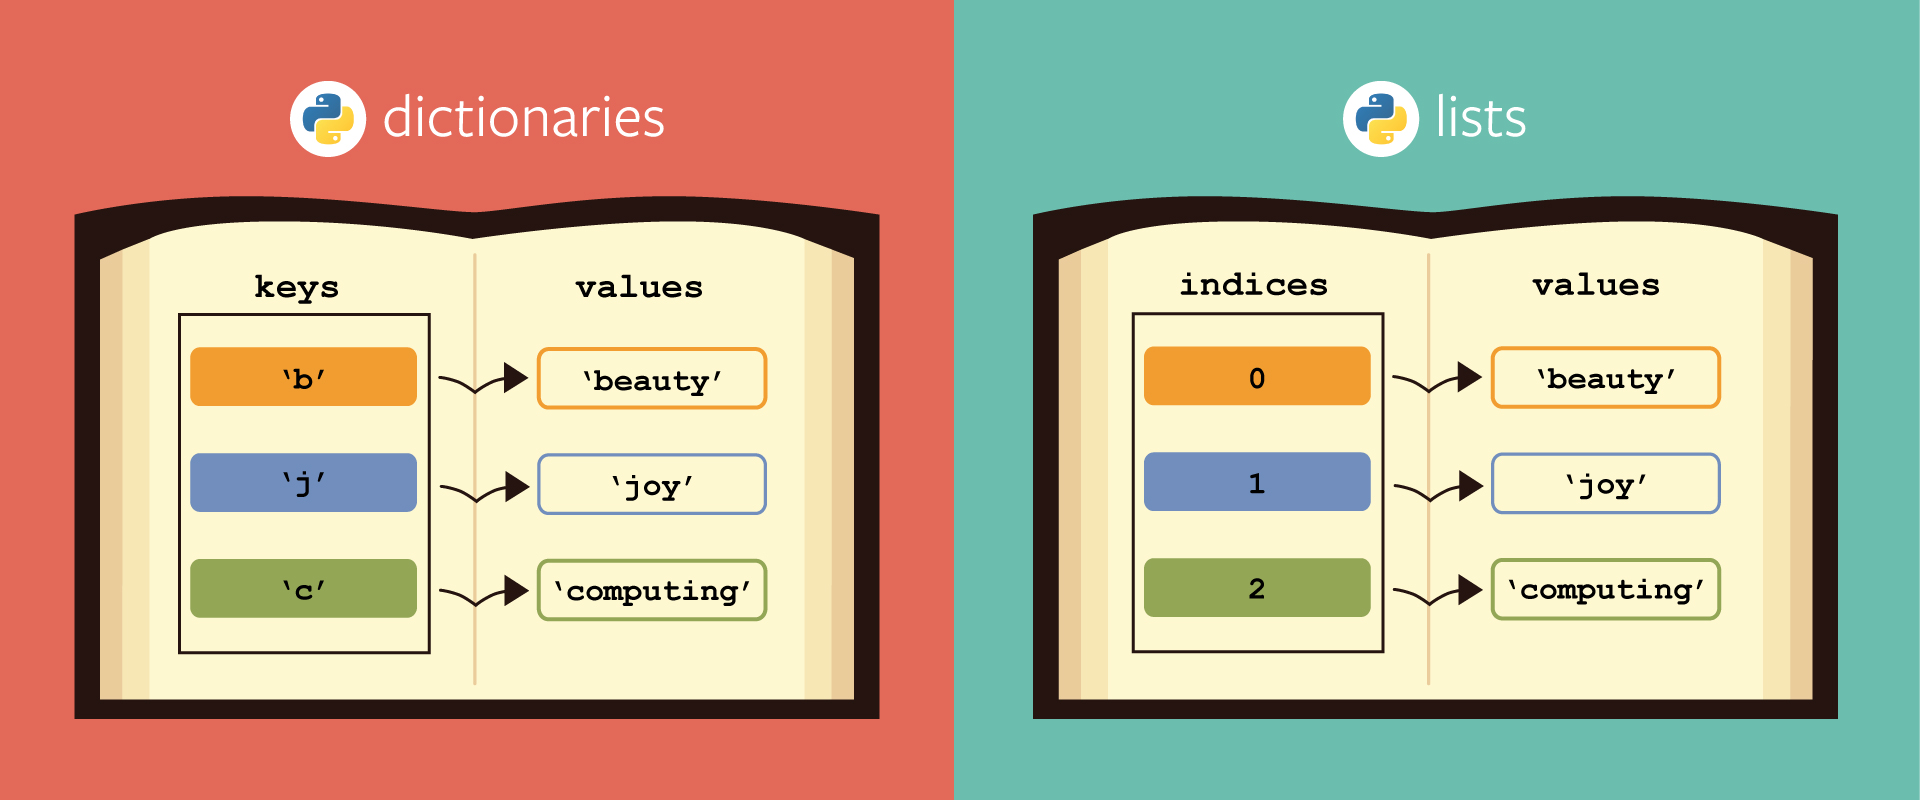
先复习一下列表如何声明和访问:
>>> list_var = [0, 1, 2, 3]
>>> list_var[0]
0
>>> list_var[1]
1
现在来对比字典的结构。
创建字典:(键必须是不可变的,比如字符串、数字、元组,但不能是列表!)
>>> empty_dict = {}
>>> full_dict = {"January": 31, "February":28, "March": 31}
访问字典:
>>> empty_dict["April"]    # 应该报错,因为这个字典里没有 "April" 键
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
KeyError: 'April'
>>> full_dict["January"]   # 应该返回与 "January" 键关联的值
31
添加和修改字典的键值对:
>>> empty_dict["April"] = 30    # 添加新的键值对
>>> empty_dict
{'April': 30}
>>> full_dict["February"] = 29  # 修改已有键的值
>>> full_dict                   # 注意字典的条目是没有顺序的
{'March': 31, 'February': 29, 'January': 31}
常用字典操作:
>>> len(full_dict)
3
>>> print ("dictionary as string: " + str(full_dict)) # str 返回可打印的字符串表示
dictionary as string: {'January': 31, 'March': 31, 'February': 29}>>> full_dict.get("April", default=False) # 键不在字典中时返回默认值
False
>>> full_dict.has_key("January")
True
>>> "January" in full_dict # 和 has_key 操作等价
True>>> full_dict.update(empty_dict) # 把 empty_dict 的所有键值对并入 full_dict
>>> full_dict
{'January': 31, 'March': 31, 'February': 29, 'April': 30}遍历字典的键:
>>> all_months = ""
>>> total_days = 0
>>> for key in full_dict:
...    all_months += key
...    all_months += " "
...    total_days += full_dict[key]
...
>>> total_days
121
>>> all_months
'January March February April '
遍历字典的值:
>>> total_days = 0
>>> for val in full_dict.values():
...    total_days += val
...
>>> total_days
121
删除:
>>> del empty_dict['April']; # 删除键为 'Name' 的条目
>>> empty_dict.clear();     # 删除字典中的所有条目
>>> del empty_dict ;        # 删除整个字典
笔记
作业题 7:字符频率
写一个函数 char_freq(),接受一个字符串,统计其中每个字符出现的频率。用 Python 字典来表示频率表,以每个字母为键,存储该字母出现的次数。
试试用 char_freq("abbabcbdbdbabdbdbabababcbcbab") 这样的输入来测试。
笔记
作业题 8.1:凯撒密码
写一个函数 rotate_letters(),接受一个数字,生成一份新的小写字母映射:每个字母按该数字偏移。把新映射以字典形式返回,原字母映射到偏移后的字母。例如,rotate_letters(2) 会把 'a'->'c'、'b'->'d'、'c'->'e',以此类推。
笔记
作业题 8.2:凯撒密码
写一个函数 decode_cipher(),接受一份字母映射字典和一个密文字符串(只含小写字母)。当每个字符都被字典中的映射替换后,返回解码得到的字符串。例如,decode_cipher(rotate_letters(2), "abc") 应该返回 "cde"。
已知字母被偏移了 13,请用这个函数解码 “jbj fpurzr vf terng”。
记忆化
现在你已经掌握了学习新主题——记忆化(memoization)——的全部工具!记忆化就是在计算过程中把计算结果(尤其是计算代价高的结果)存下来,这样以后需要重复同样的计算时,直接就有现成的答案可用。记忆化常见于优化那些包含大量重复计算的慢速递归过程。
来看生成斐波那契数列第 n 个数的 fib 函数。用递归的话,这个过程的暴力定义长这样:
def fib(n):
    return n if n < 2 else fib(n-2) + fib(n-1)
如果 n 足够大,你就要等很久 fib 才会返回。以 n 为 5 为例:我们要分别计算 fib(5-2) 和 fib(5-1)。但计算 fib(5-1) 时,又得把 fib(5-2) 重算一遍。照这个逻辑推下去,你会发现最终会有大量不必要的重复计算。
看看调用 fib(6) 生成的递归树。你能找出所有重叠的计算吗?
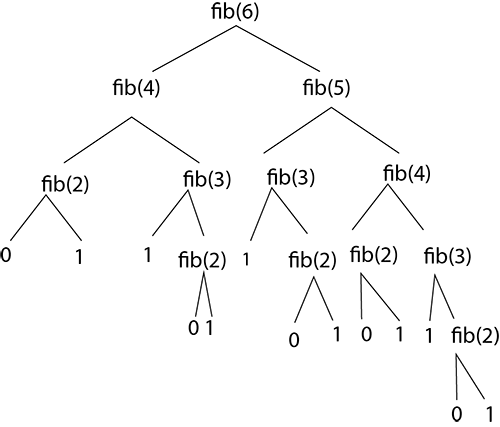
为了减少浪费,我们应该在计算完成时就把它缓存起来。然后,每次做计算之前,先查一下缓存,看这个计算是不是已经做过了。缓存可以用字典来做!键对应参数值,值对应算出的结果。
fib_cache = {}
def fib(n):
    if n in fib_cache:
        return fib_cache[n]
    else:
        fib_cache[n] = n if n < 2 else fib(n-2) + fib(n-1)
        return fib_cache[n]
这样写有点乱,因为缓存在函数外面。另一种做法是把缓存和函数包在一起,让它在包装函数的每次调用内部完成记忆化。每次调用 memo_fib() 时缓存会重置,但至少在这一次调用内部实现了记忆化。在项目 4 中,你会写一个更好的记忆化例程,既干净又能在多次调用之间保持记忆。
def memo_fib(n):
    fib_cache = {}
    def fib(n):
        if n in fib_cache:
            return fib_cache[n]
        else:
            fib_cache[n] = n if n < 2 else fib(n-2) + fib(n-1)
            return fib_cache[n]
    return fib(n)
笔记
作业题 9:阶乘累乘的记忆化
仿照 memo_fib 的写法,实现一个记忆化的阶乘累乘过程。你必须使用递归。
5 的阶乘累乘 = 5! * 4! * 3! * 2! * 1!